Parte VII · Lo computable
Lenguajes y paradigmas
Se construye sobre: Qué se puede computar, Del sumador a la CPU
Un procesador no sabe qué es una lista, ni un número par, ni una suma de cuadrados. Sabe hacer unas pocas decenas o cientos de cosas diminutas: copiar un número de la memoria a un registro, sumar dos registros, comparar, saltar a otra instrucción. Y sin embargo tú le escribes “suma los cuadrados de los pares de esta lista”, en una línea, y él lo hace. Entre esa frase y los voltajes hay una escalera de traducciones, y cada peldaño es una decisión sobre cómo conviene hablarle a una máquina. A esas decisiones les decimos lenguajes, y a las familias de decisiones parecidas, paradigmas.
Del patrón de bits a la palabra
En del sumador a la CPU armé un procesador de juguete con un programa de seis instrucciones que multiplicaba 3 por 5 sumando. Esas instrucciones, dentro de la máquina, son patrones de bits: unos bits dicen “sumar”, otros dicen “el registro R0”, otros dicen “el número 5”. Eso es el código máquina, y es el único idioma que el hardware entiende. Escribirlo a mano es posible y es miserable: un bit cambiado y el programa hace otra cosa, sin avisar.
El primer peldaño es casi una cortesía. En vez de escribir el patrón de bits se escribe una abreviatura, ADD R0, 5, y un programa llamado ensamblador la traduce al patrón. La correspondencia es casi uno a uno: cada línea de ensamblador es una instrucción de la máquina. Ganas legibilidad, pero sigues pensando como el procesador, registro por registro, y lo que escribes para un tipo de procesador no corre en otro. Todavía hoy, en un microcontrolador que tiene que responder en microsegundos, a veces se baja a ese nivel.
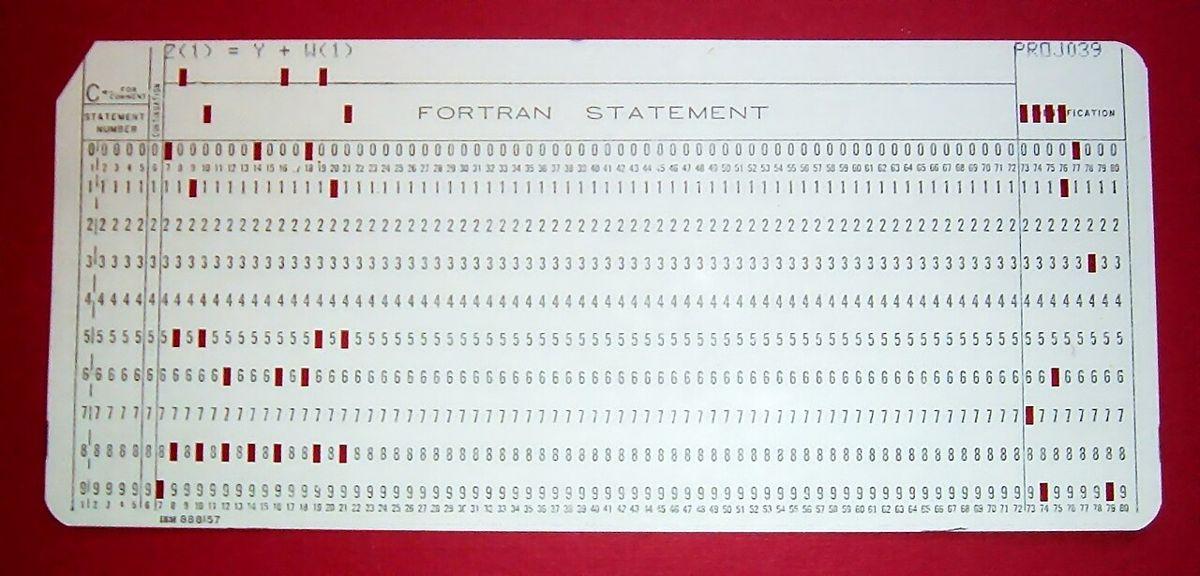
El salto grande es el compilador: un programa que lee un texto escrito en un lenguaje pensado para personas y produce código máquina equivalente. Que eso fuera posible no era obvio. A comienzos de los años cincuenta muchos dudaban de que una traducción automática pudiera producir código tan eficiente como el escrito a mano, y Grace Hopper estuvo entre quienes insistieron en que sí. La prueba de fuego fue Fortran, que un equipo de IBM dirigido por John Backus entregó en 1957: se podía escribir una fórmula casi como en el papel, y el código que salía era lo bastante rápido como para que los científicos lo adoptaran.
Hay una segunda manera de cruzar el puente. Un intérprete no traduce el programa entero de antemano: lo lee y lo va ejecutando, instrucción por instrucción. Es más lento, pero más flexible, y en la práctica la frontera se borró. Python compila tu código a un lenguaje intermedio, el bytecode, que luego interpreta una máquina virtual; los motores de JavaScript de los navegadores empiezan interpretando y compilan sobre la marcha las partes que más se repiten. Todo esto es posible por la idea del programa almacenado: un programa es un dato más, así que un programa puede leer, transformar y producir otros programas.
Una historia muy corta
Un año después de Fortran, en 1958, John McCarthy propuso Lisp, que venía de otro mundo: tomaba su notación de funciones del cálculo lambda de Alonzo Church, el modelo de cómputo hecho solo de definir funciones y aplicarlas que aparece en qué se puede computar. En Lisp los programas se escriben con la misma estructura que los datos, listas, y por eso un programa Lisp puede manipular programas Lisp con naturalidad. En 1972 Dennis Ritchie, en los Laboratorios Bell, creó C: un lenguaje lo bastante cercano a la máquina como para escribir con él un sistema operativo (con él se reescribió Unix) y lo bastante abstracto como para llevarlo de un procesador a otro. Buena parte del software que sostiene el mundo, sistemas operativos, bases de datos, intérpretes, sigue escrito en C o en sus descendientes.
En 1991 Guido van Rossum publicó Python, que apostó por la legibilidad por encima de casi todo, y en 1995 Brendan Eich creó JavaScript en Netscape para darle comportamiento a las páginas web. Ninguno de los dos se pensó para lo que terminó haciendo: Python se volvió el idioma de la ciencia de datos y de las redes neuronales, y JavaScript, el único lenguaje que todos los navegadores ejecutan, terminó también en los servidores. Esta misma página está escrita en TypeScript, que Microsoft presentó en 2012 como JavaScript con tipos.
El mismo problema, tres maneras
Un paradigma no es un lenguaje; es una manera de descomponer un problema, y la mayoría de los lenguajes de hoy admiten varias. La forma más clara de verlo es resolver lo mismo de distintas maneras. El problema: dada una lista de enteros, sumar los cuadrados de los que son pares. En matemáticas se escribe sin pensar en pasos:
Para , los pares son 4, 2 y 6, y la suma es . Veamos cómo lo dice cada paradigma.
Suma los cuadrados de los números pares de la lista. Avanza el programa imperativo paso a paso y mira cómo cambian sus variables; las otras dos versiones no tienen pasos que mirar, solo un resultado.
imperativo · cómo, paso a paso
total = 0para cada x en lista:si x es par:total = total + x * xdevolver total
variables
| paso | 1 de 17 |
| x | — |
| total | 0 |
funcional · qué se le hace a la lista
lista
  .filter(x => x % 2 === 0)   // [4, 2, 6]
  .map(x => x * x)            // [16, 4, 36]
  .reduce((a, b) => a + b, 0) // 56
declarativo · qué se quiere
SELECT SUM(x * x)
FROM numeros
WHERE x % 2 = 0;
-- 3 filas pasan el WHERE
-- resultado: 56
Empieza el total en 0.
Imperativo. Le das a la máquina una secuencia de órdenes que van cambiando un estado: “pon el total en cero; para cada elemento, si es par, súmale su cuadrado al total”. Es el estilo más cercano al procesador, que no hace otra cosa que modificar registros. Hay una forma precisa de pensarlo. Llama al conjunto de estados posibles, es decir, de asignaciones de valores a las variables. Cada instrucción es una función , y un programa que es una simple secuencia de asignaciones es la composición de las suyas:
El intérprete de la animación hace exactamente eso: aplica una instrucción, muestra el nuevo estado, aplica la siguiente. Con la lista de ejemplo da 17 pasos, y el total solo cambia tres veces, en 16, 20 y 56. Las decisiones y los ciclos complican la fórmula (un ciclo que no termina no define ningún estado final, y por eso lo que calcula un programa es en general una función parcial), pero la idea de fondo es esa.
Dentro de lo imperativo hubo una disciplina que hoy damos por sentada. En los primeros lenguajes era común saltar de cualquier línea a cualquier otra con una instrucción GOTO, y los programas grandes se volvían un nudo. Corrado Böhm y Giuseppe Jacopini probaron en 1966 que basta con tres formas de combinar instrucciones (una detrás de otra, elegir entre dos caminos y repetir mientras se cumpla una condición) para expresar cualquier función computable, y en 1968 Edsger Dijkstra publicó una carta muy citada contra el uso del GOTO. De ahí viene la programación estructurada: el if y el while de todos los días.
Orientado a objetos. Sigue siendo imperativo, pero reparte el estado. En vez de un montón de variables sueltas, el programa se organiza en objetos que guardan sus propios datos y ofrecen operaciones sobre ellos: una cuenta bancaria sabe su saldo y sabe recibir un depósito, y nadie de afuera toca el saldo directamente. La idea viene de Simula, un lenguaje noruego de los años sesenta pensado para simulaciones, y la llevó lejos Smalltalk, en Xerox PARC, en los setenta. Su promesa es de escala: si cada pieza protege su estado, un sistema de un millón de líneas se puede entender por partes. Para sumar cuadrados no aporta casi nada; para modelar un banco, mucho.
Funcional. Aquí se renuncia a cambiar cosas. Un programa es una composición de funciones en el sentido matemático estricto: funciones puras, cuya salida depende solo de su entrada y que no modifican nada afuera. La lista no se recorre con un contador; se le aplica un filtro, luego una transformación, luego una reducción, y cada etapa produce una lista nueva sin tocar la anterior. Esa inmutabilidad trae una propiedad valiosa, la transparencia referencial: cualquier expresión se puede reemplazar por su valor sin cambiar el programa, como en álgebra. Si , donde dice puedo escribir 9. En un programa imperativo eso falla en cuanto una función depende de algo que otra parte del código pudo haber cambiado. La reducción final tiene una definición recursiva limpia:
Con y es la suma de una lista, y es la sumatoria de arriba escrita como programa.
Lógico y declarativo. El último paso es dejar de decir cómo y decir solo qué. En SQL escribes “la suma de sobre las filas donde es par”, y es el motor el que decide en qué orden leer, si usa un índice, si reparte el trabajo; lo cuento en bases de datos. La programación lógica, con Prolog a comienzos de los setenta como ejemplo clásico, lleva la idea más lejos: escribes hechos y reglas, “un abuelo es el padre de un padre”, y le preguntas al sistema qué se deduce. Debajo hay lógica de primer orden, la misma de los cuantificadores de axiomas y conjuntos.
Tipos: lo que el lenguaje no te deja decir
Todo valor en un programa tiene un tipo: entero, texto, lista de fechas, cliente. Los lenguajes se distinguen por dos preguntas sobre los tipos, que conviene no confundir. La primera es cuándo se revisan. En un lenguaje de tipado estático, como C, Java o TypeScript, el compilador revisa los tipos antes de que el programa corra y rechaza el que intente, por ejemplo, multiplicar una fecha por un texto. En uno de tipado dinámico, como Python o JavaScript, los valores llevan su tipo consigo y el error aparece cuando la línea culpable se ejecuta, que puede ser meses después, en producción. En mis notas sobre tipado dejé resaltada justamente esa idea: es peligroso que los errores solo salgan cuando el programa ya está corriendo.
La segunda pregunta es cuánto se tolera la mezcla. Un lenguaje de tipado fuerte se niega a convertir tipos por su cuenta; uno débil los convierte en silencio. Las dos preguntas son independientes. Python es dinámico y bastante fuerte: "1" + 1 es un error. JavaScript es dinámico y débil: "1" + 1 da "11" y "1" - 1 da 0, porque convierte en direcciones opuestas según el operador. Hay que decir que “fuerte” y “débil” no tienen una definición formal aceptada por todos; son una escala, no una frontera. TypeScript agrega revisión estática encima de JavaScript, y es un caso curioso: los tipos se revisan al compilar y luego se borran, así que en el programa que corre ya no existen.
Un sistema de tipos es, en el fondo, una demostración barata. Cuando el compilador acepta un programa, ha probado un teorema sobre él: “esta función siempre devuelve un número”. Hay una correspondencia formal, la de Curry y Howard, entre tipos y proposiciones lógicas, y entre programas y demostraciones, que convierte esa analogía en un resultado preciso para ciertos sistemas de tipos. Y aquí vuelve el problema de la parada: por el teorema de Rice, ningún revisor automático puede decidir, para todos los programas, una propiedad no trivial de lo que hacen al correr. Por eso un revisor de tipos que siempre termina y nunca deja pasar cierta clase de error tiene que ser conservador: rechaza algunos programas que habrían funcionado bien, a cambio de garantizar que los que acepta no tienen ese error.
Todos pueden lo mismo, y no da igual
Hay un hecho que pone todo esto en su lugar. Cualquier lenguaje de propósito general, con memoria ilimitada, calcula exactamente las mismas funciones que una máquina de Turing: son Turing-equivalentes. No hay un problema que Python resuelva y C no, ni al revés. Lo que un paradigma no puede darte es poder de cómputo nuevo; eso lo cerró la tesis de Church–Turing. Lo curioso es que algunos de los lenguajes más útiles renuncian a la universalidad a propósito: el núcleo clásico de SQL, sin consultas recursivas, no es Turing-completo, y a cambio toda consulta termina.
Entonces, ¿por qué importan? Por lo mismo que importa la notación en matemáticas. Los números romanos y los arábigos representan los mismos números, y nadie quiere multiplicar en romanos. Un lenguaje decide qué es fácil de decir, qué es difícil y qué es imposible de decir por accidente. Si el lenguaje no te deja modificar una variable, no puedes modificarla sin querer; si los tipos se revisan antes de correr, cierta clase de error nunca llega al usuario; si la consulta es declarativa, el motor puede elegir un plan que tú no habrías encontrado. La complejidad de un algoritmo no depende del lenguaje, pero la probabilidad de escribirlo bien a la primera, sí.
Por eso tiene poco sentido preguntar cuál es el mejor. Cada paradigma nació para llenar un vacío que dejaba otro, y casi todo lo que construyo mezcla varios: componentes que se parecen a funciones puras que reciben datos y devuelven una interfaz, un poco de estado donde no hay más remedio, y consultas declarativas cuando toca hablar con la base de datos. Al final todos bajan por la misma escalera hasta los mismos interruptores. Lo que cambia es cuánto de tu atención se va en pensar el problema y cuánto en pelear con la máquina.