Parte VIII · Los datos
Teoría del aprendizaje: por qué aprender de ejemplos funciona
Se construye sobre: Aprendizaje automático, Probabilidad
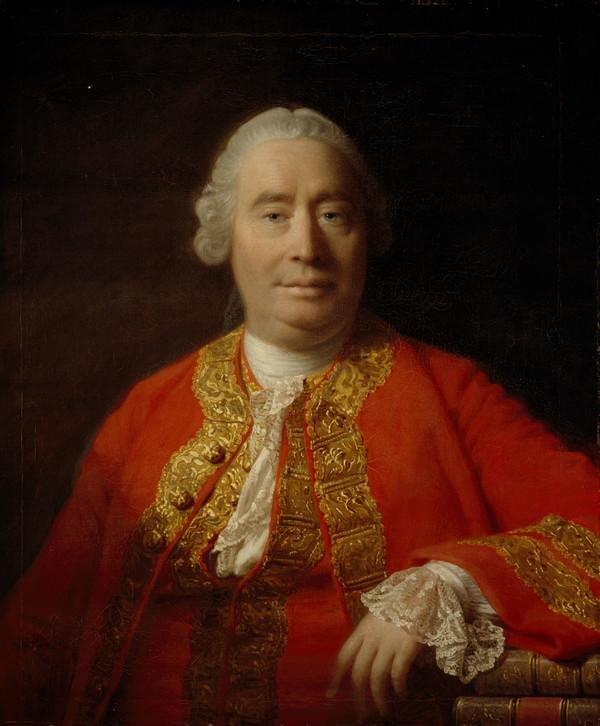
Un modelo ve diez mil fotos de gatos y de perros, y después acierta con una foto que nunca vio. ¿Por qué debería? Nada en las diez mil fotos obliga a la siguiente a parecerse. Es una pregunta vieja con ropa nueva: en 1739, el filósofo escocés David Hume preguntó qué nos autoriza a creer que el sol saldrá mañana solo porque siempre ha salido, y concluyó que nada lo justifica con lógica pura. Lo creemos por costumbre.
En aprendizaje automático di una respuesta corta: más datos y modelos más simples. La teoría del aprendizaje es la rama de las matemáticas que convierte esa frase en teoremas. No refuta a Hume (nada lo hace), pero dice con precisión cuánto hay que apostar, y bajo qué supuestos, para que aprender de ejemplos funcione. Y al final, de manera inesperada, se encuentra con la teoría de juegos.
Probablemente, aproximadamente, correcto
En 1984, el científico de la computación Leslie Valiant propuso una definición de qué significa aprender que todavía usamos. Su nombre en inglés lo resume: aprendizaje probablemente aproximadamente correcto, o PAC. Las dos palabras con “mente” son las concesiones honestas.
- Aproximadamente correcto: no pedimos que el modelo nunca se equivoque, sino que su error en casos nuevos sea a lo sumo un pequeño, digamos un 5 %.
- Probablemente: la muestra de ejemplos es al azar, y siempre puede tocarnos una muestra engañosa (diez mil fotos de gatos blancos). Pedimos que eso pase con probabilidad a lo sumo , digamos un 1 %.
Una familia de modelos se puede aprender si, para cualquier y , basta un número razonable de ejemplos para lograrlo. Y el supuesto que lo sostiene todo es el de Hume, pero escrito como hipótesis explícita: los ejemplos y los casos futuros salen de la misma distribución, al azar. Si el mundo cambia, la garantía se cae, y la teoría lo dice en voz alta en lugar de esconderlo.
Para una familia finita de modelos, y si alguno de ellos es perfecto, la cuenta es sencilla. Un modelo con error mayor que acierta un ejemplo al azar con probabilidad menor que , así que acertar seguidos por pura suerte tiene probabilidad menor que . Sumando sobre todos los modelos malos y pidiendo que el total sea menor que :
Con un millón de modelos posibles, 5 % de error y 1 % de riesgo, salen 369 ejemplos. Lo notable es el logaritmo: multiplicar por mil el número de modelos solo suma unas 140 muestras. Pero los modelos que usamos tienen parámetros reales, que pueden tomar infinitos valores, y ahí es infinito. Hace falta otra manera de medir el tamaño.
Cuántos patrones puede imitar una familia
La respuesta la dieron en 1971 dos matemáticos soviéticos, Vladímir Vapnik y Alekséi Chervonenkis. La idea es no contar modelos, sino contar comportamientos: en cuántas maneras distintas puede la familia clasificar un conjunto de puntos. Si para unos puntos la familia logra los etiquetados posibles, se dice que los rompe: puede imitar cualquier patrón que le pongas, y por lo tanto que acierte en ellos no dice nada. La dimensión VC es el mayor número de puntos que la familia logra romper.
El ejemplo clásico son las rectas en el plano, que separan los puntos en dos lados. Pruébalo:
Toca para poner hasta cuatro puntos; toca uno para quitarlo.
Hay 8 maneras de pintar los 3 puntos de azul o ocre. Una recta logra separar 8. Las logra todas: la recta rompe este conjunto.
Con tres puntos que no estén en línea, la recta logra los ocho patrones: los rompe. Con tres en línea falla uno, el del punto del medio distinto a los extremos, pero basta con que exista un conjunto de tres que se rompa. Con cuatro, en cambio, no hay manera: pon los puntos donde quieras y siempre fallará alguno. En el cuadrado fallan las dos diagonales, el famoso patrón del “o exclusivo” que en 1969 sirvió para mostrar los límites de las primeras redes neuronales de una sola capa. La dimensión VC de las rectas en el plano es 3. En general, las separaciones con un plano en dimensiones tienen dimensión .
¿Por qué importa? Por un resultado sorprendente, el lema de Sauer y Shelah (1972). Si una familia tiene dimensión VC igual a , el número de patrones que puede producir con puntos no es sino a lo sumo
Un polinomio, no una exponencial. Con 40 puntos hay más de un billón de patrones posibles, y el lema garantiza que las rectas del plano no producen más de 10.701 (la cuenta exacta, con los puntos en posición general, da apenas 1.562). Esa diferencia es la que permite aprender: como la familia no puede imitar casi nada de lo que podría pasar, que acierte en muchos datos sí es evidencia de que encontró algo. El teorema fundamental del aprendizaje PAC lo cierra: una familia se puede aprender si y solo si su dimensión VC es finita, y los ejemplos necesarios crecen, más o menos, como .
Hay un detalle que me encanta: la dimensión VC no es el número de parámetros. La familia de clasificadores que dicen “sí” cuando tiene un solo parámetro, la frecuencia , y sin embargo su dimensión VC es infinita: subiendo la frecuencia, la onda se puede retorcer lo suficiente para imitar cualquier patrón en puntos bien escogidos. Lo que mide la complejidad no es cuántas perillas tiene un modelo, sino cuánto puede doblarse.
No hay almuerzo gratis
Todo lo anterior supone que escogimos una familia de antemano. ¿Y si quisiéramos un método que aprenda cualquier cosa, sin suponer nada? En 1996, David Wolpert demostró que no existe. Promediando sobre todos los problemas posibles, ningún método de aprendizaje es mejor que otro en los casos que no ha visto; ni siquiera mejor que adivinar. Si un método gana en unos problemas, pierde exactamente lo mismo en otros.
El teorema de “no hay almuerzo gratis” es Hume con demostración. Aprender siempre exige una apuesta previa sobre cómo es el mundo: que las funciones son suaves, que los vecinos se parecen, que las explicaciones cortas son mejores. A esa apuesta se le llama sesgo inductivo. La pregunta no es si un método tiene sesgo, sino si su sesgo coincide con el mundo en el que lo vamos a usar. La red que reconoce caras funciona porque las caras tienen estructura, y su arquitectura apuesta por esa estructura. Es la misma idea que aparece en qué es saber: todo conocimiento empírico descansa en algo que no se puede demostrar desde los datos solos.
El enigma de las redes enormes
Aquí la teoría tiene una deuda pendiente, y vale la pena decirlo. Las redes neuronales de hoy tienen muchos más parámetros que ejemplos de entrenamiento. Según las cotas clásicas, deberían memorizar los datos y fracasar con los nuevos. En 2017, un grupo de investigadores de Google, el MIT y Berkeley hizo un experimento brutal: tomaron una red estándar de reconocimiento de imágenes y la entrenaron con etiquetas puestas al azar. La red las memorizó todas, sin error. O sea: su capacidad alcanza para romper el conjunto de entrenamiento entero. Y sin embargo, la misma red, entrenada con las etiquetas verdaderas, generaliza muy bien.
En 2019, Mikhail Belkin y su equipo describieron un fenómeno que lo vuelve todavía más raro, el doble descenso. Al agrandar un modelo, el error en datos nuevos primero baja, luego sube cuando el modelo apenas alcanza a memorizar (el sobreajuste clásico del capítulo de aprendizaje automático) y después, si se sigue agrandando mucho más allá de ese punto, vuelve a bajar. Entre las explicaciones que se discuten están que el entrenamiento, entre todas las soluciones que memorizan los datos, tiende a encontrar las más simples, y que los datos reales tienen una estructura mucho más pobre que el peor caso que suponen las cotas. Pero no hay todavía una teoría que lo explique del todo. Es uno de los problemas abiertos más importantes de la disciplina.
Aprender sin suponer nada: el arrepentimiento
Hay otra manera de plantear el aprendizaje, y es la que más me gusta, porque renuncia a la hipótesis de Hume. Olvida que los datos salen de una distribución fija. Imagina que cada día tienes que decidir, y después ves cómo te fue, y que los resultados los escoge un adversario, quizás para fastidiarte. No se puede prometer acertar. ¿Qué se puede prometer?
La respuesta es un concepto muy humano, el arrepentimiento: la diferencia entre lo que ganaste y lo que habrías ganado si hubieras usado, todos los días, la mejor opción fija vista en retrospectiva. Un método tiene arrepentimiento que se desvanece si esa diferencia, dividida por el número de días, tiende a cero. A la larga, nadie te puede decir “si siempre hubieras hecho X te habría ido mejor”. La idea viene de James Hannan y David Blackwell, en los años cincuenta.
El método más famoso es casi infantil, el de los pesos multiplicativos. Tienes opciones, cada una con un peso. Escoges al azar en proporción a los pesos. Al final del día, multiplicas el peso de cada opción por : lo que habría funcionado crece, lo que no, se encoge. Con el adecuado y ganancias entre 0 y 1, después de días
Lo pulieron Nick Littlestone y Manfred Warmuth a finales de los ochenta, y Yoav Freund y Robert Schapire en los noventa, que con la misma idea inventaron además el boosting: combinar muchos clasificadores mediocres, pesándolos así, hasta lograr uno muy bueno.
Cuando los dos aprenden
Ahora junta las piezas. Pon a jugar el penal de teoría de juegos a un pateador y un arquero que no saben nada de von Neumann. Cada uno usa pesos multiplicativos: después de cada ronda, mira cuánto gol habría salido con cada lado contra lo que hizo el otro, y ajusta sus pesos.
ronda 1
● Lo que juegan ahora: pateador 10 %, arquero 80 %.
● Su promedio: pateador 10 %, arquero 80 %.
◎ Equilibrio de von Neumann: 44 % y 42 %.
Arrepentimiento del pateador por ronda: 1,76 puntos de gol.
Mira las dos líneas. Lo que cada uno juega en el momento (la ocre) nunca se queda quieto: el pateador se carga a un lado, el arquero lo nota y lo persigue, el pateador se va al otro, y así en vueltas cada vez más amplias, como dos personas que se esquivan en un pasillo. Pero el promedio de lo que han jugado (la azul) se va acercando al círculo del equilibrio de von Neumann, 44 % y 42 %, sin que ninguno lo haya calculado. Y el arrepentimiento por ronda baja hacia cero.
No es suerte del ejemplo. Freund y Schapire demostraron en 1999 que si los dos jugadores de un juego de suma cero usan métodos con arrepentimiento que se desvanece, sus promedios convergen al equilibrio. Eso es, de paso, una demostración del teorema minimax de von Neumann hecha con aprendizaje: como ninguno de los dos se puede arrepentir a la larga, lo que el pateador se asegura y lo que el arquero concede tienen que coincidir. Y es, con muchas mejoras, la idea con la que los programas de póker aprendieron a jugar. Libratus, el que le ganó a profesionales en 2017, se entrenó jugando contra sí mismo en un supercomputador con una variante llamada minimización del arrepentimiento contrafactual. Nadie le enseñó a farolear. Lo aprendió porque, a la larga, no hacerlo le habría dado arrepentimiento.
Me gusta terminar aquí porque se cierra un círculo. Hume decía que aprendemos por costumbre, sin justificación lógica. La teoría del aprendizaje no le contesta con una justificación. Le contesta con algo más modesto y más útil: si apuestas a que el futuro se parece al pasado, esto es cuánto necesitas ver; y si no quieres apostar a nada, todavía puedes garantizar que, a la larga, no te vas a arrepentir.