Parte VII · Lo computable
Ruido, canales y códigos
Se construye sobre: Entropía e información, Anillos y cuerpos
Un código QR pegado en la mesa de un restaurante, con una mancha de salsa encima, todavía abre el menú. Un CD rayado sigue sonando. Una sonda que lleva décadas saliendo del sistema solar manda datos con una antena que transmite con menos potencia que un bombillo, y aquí abajo los recibimos completos. En todos esos casos el mensaje se dañó en el camino, y aun así llegó entero. ¿Cómo?
La respuesta corta es que nadie mandó solo el mensaje. Mandaron el mensaje y algo más, una redundancia calculada con tanto cuidado que el daño se delata a sí mismo. Este capítulo es sobre cuánta información cabe en un canal que comete errores, una pregunta que Shannon resolvió con un teorema asombroso, y sobre los códigos que convierten esa promesa en aparatos.
El canal y su ruido
Un canal es cualquier cosa que lleva símbolos de un lugar a otro, o de un momento a otro: un cable, el aire, la superficie de un disco, una memoria. Y todo canal real tiene ruido. Los electrones de un conductor se agitan con la temperatura, y esa agitación (que es termodinámica pura) se suma a la señal; las ondas de radio comparten el espectro con otras fuentes; un rayón se lleva un pedazo del disco. A la salida, de vez en cuando, un 0 llega como 1.
El modelo más simple, y sorprendentemente útil, es el canal binario simétrico: entra un bit, y con probabilidad sale volteado, con probabilidad sale igual, cada bit independientemente de los demás. Con , uno de cada diez bits llega mal. ¿Se puede, con un canal así, mandar un archivo sin un solo error?
Repetir y votar
La primera idea es la de quien no oye bien por teléfono: repetir. Manda cada bit tres veces y, del otro lado, decide por mayoría. Solo te equivocas si se dañan dos o las tres copias, y eso pasa con probabilidad
Con el error baja del 10 % al 2,8 %; con , del 1 % al 0,03 %. Funciona. Pero es caro: por cada bit útil gastas tres, la tasa del código es . Y si quieres un error más pequeño tienes que repetir cinco, siete, cien veces, y la tasa se va a cero. Antes de 1948, lo razonable era pensar que así es el mundo: que la confiabilidad se paga con velocidad, y que el error cero solo se alcanza sin mandar nada.
El teorema que nadie esperaba
Shannon demostró lo contrario. En el mismo artículo de 1948 donde definió la entropía, probó que todo canal tiene un número, su capacidad , con esta propiedad: para cualquier tasa y cualquier probabilidad de error , por pequeña que sea, existe un código de tasa al menos cuyo error es menor que , siempre que se permita codificar bloques suficientemente largos. Y por encima de la capacidad no se puede: con , la probabilidad de error no baja de cierto valor positivo, uses el código que uses.
Para el canal binario simétrico la capacidad tiene una forma hermosa:
Se lee así: cada bit que mandas podría llevar un bit de información, pero el ruido le inyecta bits de incertidumbre, la entropía de una moneda que cae “volteado” con probabilidad , y eso es lo que hay que descontar. Con , la capacidad es 0,531: con códigos bien hechos se puede mandar más de medio bit de información por cada bit enviado, con tan pocos errores como quieras. No hay que dejar la tasa ir a cero; basta con quedarse debajo de 0,531. Con , la capacidad es 0,919. Con es cero: la salida es una moneda al aire que no sabe nada de la entrada. Y con vuelve a ser uno, porque un canal que lo voltea todo no esconde nada: basta con voltear de vuelta.
La prueba de Shannon es tan ingeniosa como frustrante. Muestra que si eliges las palabras del código al azar, en bloques largos, en promedio funcionan: casi ningún código es malo. Pero no dice cuál usar, ni cómo decodificarlo rápido. Encontrar códigos que se acerquen a la capacidad y que se puedan decodificar en un tiempo razonable tomó casi medio siglo. En general no es fácil: decodificar un código lineal cualquiera de la forma óptima es un problema NP-difícil.
Hamming y sus bits de paridad
Mientras tanto, en los mismos Laboratorios Bell, Richard Hamming tenía un problema práctico. Usaba computadores de relés que detectaban algunos errores pero, al detectarlos, se detenían. Él mismo contó después que lo que lo empujó fue perder trabajos enteros del fin de semana, cuando no había operadores que reiniciaran la máquina. Si la máquina podía saber que había un error, ¿por qué no podía saber dónde estaba y arreglarlo? Su artículo sobre códigos que detectan y corrigen errores salió en 1950.
El más famoso es el código de Hamming (7,4): toma 4 bits de datos y manda 7. Numera las posiciones del 1 al 7. En las posiciones que son potencias de dos, 1, 2 y 4, van bits de paridad; en las demás, 3, 5, 6 y 7, van los datos. Cada bit de paridad vigila las posiciones cuyo número, escrito en binario, tiene encendido su bit: el de la posición 1 vigila 1, 3, 5 y 7 (los impares); el de la 2 vigila 2, 3, 6 y 7; el de la 4 vigila 4, 5, 6 y 7. Y cada uno se escoge para que su grupo tenga un número par de unos. Esa suma par es un o exclusivo, la misma operación que un circuito hace con una compuerta XOR.
Cada círculo debe tener un número par de unos. El bit dañado es el único que está dentro de todos los círculos que fallan y fuera de los que cuadran.
Llegó intacto: los tres controles cuadran y el síndrome es 0.
Con p = 0,10: repetir cada bit tres veces falla en 2,8 % de los bits gastando 3 por cada uno; Hamming (7,4) pierde 15,0 % de los bloques gastando 7 por cada 4. La capacidad del canal es 0,531 bits por bit enviado.
Prueba a dañar un bit. Al llegar, el receptor recalcula las tres paridades. Las que fallan, leídas como un número binario, forman el síndrome, y el síndrome es exactamente la posición del bit dañado. Si se dañó el 5 (101 en binario), fallan los controles de las posiciones 1 y 4, y no el de la 2. Si no se dañó nada, el síndrome es 000. La idea de los tres círculos dice lo mismo en dibujo: cada posición vive en una región distinta del diagrama, y el bit culpable es el único que está dentro de todos los círculos que fallan y fuera de todos los que cuadran.
Debajo del truco hay álgebra lineal sobre el cuerpo de dos elementos, el del capítulo de anillos y cuerpos, donde . Las palabras del código forman un subespacio de dimensión 4 dentro de , y los tres controles son una matriz cuyas columnas son los números del 1 al 7 en binario:
Si llega , con el patrón de errores, entonces : el síndrome no depende del mensaje, solo del daño. Y si el daño es un solo bit en la posición , es la columna , que es en binario.
Distancia y honestidad
La distancia de Hamming entre dos cadenas de bits es el número de posiciones en que difieren. Entre dos palabras cualesquiera del código (7,4) hay distancia al menos 3. Eso es lo que lo hace funcionar: si te imaginas una bola de radio 1 alrededor de cada palabra, con ella y las siete cadenas a un bit de distancia, ninguna bola toca a otra. Un error te saca de tu palabra pero te deja dentro de su bola, y el decodificador te devuelve al centro. En general, un código con distancia mínima corrige hasta errores.
Este código, además, es perfecto: 16 palabras con bolas de 8 cadenas cada una dan . Las bolas cubren todas las cadenas posibles sin dejar huecos. Cualquier cosa que llegue está a lo sumo a un bit de exactamente una palabra.
Y esa misma perfección es la razón de su límite. Toca “probar con dos errores” en la animación. Con dos bits dañados, lo que llega cae en la bola de otra palabra; el síndrome no es cero, así que el receptor sabe que algo pasó, pero señala un tercer bit que estaba bien. El decodificador lo “corrige” y entrega tres errores en vez de dos. El código no miente sobre lo que promete: corregir uno. Si se le agrega un octavo bit de paridad sobre todo el bloque, puede corregir un error y además detectar dos sin confundirlos, y esa versión extendida es la idea detrás de la memoria con corrección de errores de muchos servidores, la que protege los bits que maneja una CPU de un rayo cósmico ocasional.
Las cifras del final de la animación ponen a Hamming junto a Shannon. Con , el (7,4) pierde cerca del 0,2 % de los bloques con tasa , mucho mejor negocio que repetir tres veces. Pero la capacidad es 0,919, y con el (7,4) ya pierde alrededor del 15 % de los bloques. Entre lo que un código corto logra y lo que el teorema promete hay mucho espacio.
Del QR a la Voyager
Los códigos de Reed–Solomon, que el capítulo de anillos y cuerpos presenta sobre un cuerpo de 256 elementos, juegan el mismo juego con otra pieza básica: en vez de bits, sus símbolos son bytes enteros. Eso los hace muy buenos contra el daño en ráfagas, como una mancha o un rayón, que arruina muchos bits seguidos pero pocos símbolos. Un QR trae uno de cuatro niveles de corrección, que permiten recuperar más o menos el 7, el 15, el 25 o el 30 % de sus bytes; los CD de música los usan dos veces, entrelazados, para que un rayón se reparta entre muchos bloques.
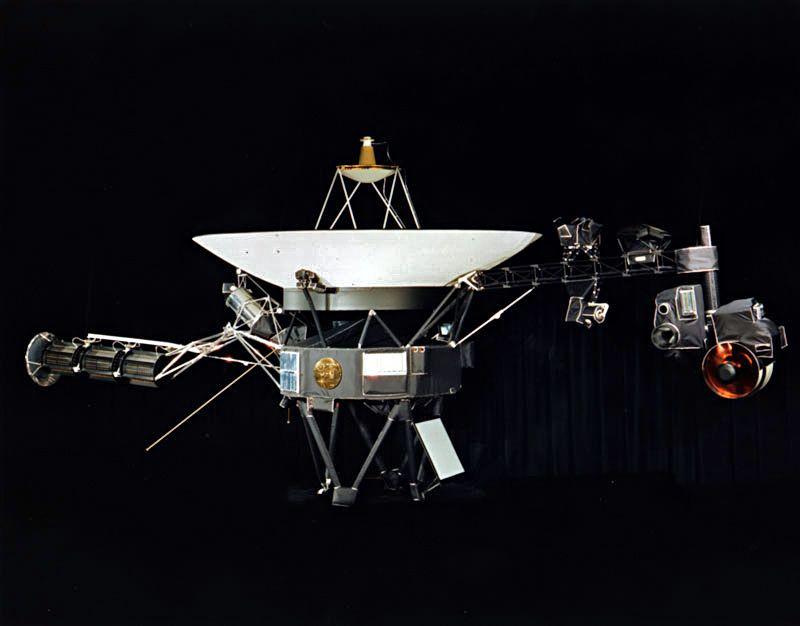
Las sondas Voyager, lanzadas en 1977, combinaron varios códigos a lo largo de su viaje, entre ellos un código convolucional y, para los encuentros más lejanos, una capa de Reed–Solomon por encima. Y la promesa de Shannon por fin se volvió práctica en los años noventa, con los turbo códigos (1993) y el redescubrimiento de los códigos LDPC, que Robert Gallager había propuesto en los sesenta y que en su momento eran demasiado costosos de decodificar. Los dos llegan muy cerca de la capacidad, y por eso están en las redes de telefonía celular, en el Wi-Fi moderno y en la televisión satelital.
Redundancia, por todas partes
Mirado desde aquí, el idioma es un código corrector bastante bueno. Como se ve en el capítulo de n-gramas, un idioma escrito usa mucho menos de los casi cinco bits que cabrían en cada letra (Shannon lo estimó, para el inglés, del orden de uno), y esa redundancia es lo que te deja leer “c_nversaci_n” sin dudar. No es un diseño, es una costumbre, pero cumple la misma función que los bits de paridad: gastar espacio para comprar seguridad.
Con la vida hay que ser más cuidadoso. El código genético de las moléculas de la vida también es redundante: hay 64 tripletas posibles y solo unos 20 aminoácidos más las señales de parada, así que muchas mutaciones de una letra no cambian la proteína. Pero eso no lo convierte en un código de Hamming; no hay síndrome que señale la letra dañada. La célula protege su ADN de otra forma: con la doble hebra, donde cada mitad sirve de copia de respaldo de la otra, y con maquinaria que revisa y repara.
Lo que más me impresiona de esta historia es el orden en que pasó. Primero vino el teorema, que decía que el ruido no es una condena sino un costo con precio conocido, bits por bit. Después vinieron décadas de ingenio para pagar ese precio y no más. Hamming, con sus tres círculos, dio el primer paso práctico. Cada vez que un QR manchado abre el menú, se está cobrando un pedazo de esa promesa.