Parte III · Lo incierto
Entropía e información
Se construye sobre: Probabilidad
Si mañana alguien me dice que en Pereira salió el sol, no me dice nada. Si me dice que nevó en la plaza de Bolívar, me deja frío, y no solo por la nieve. Las dos frases tienen más o menos el mismo largo, pero una no trae noticia y la otra cambia por completo lo que sé del mundo. Intuitivamente, la información de un mensaje no está en cuántas letras tiene, sino en cuánto nos sorprende.
Este capítulo es sobre cómo medir esa sorpresa con un número, y sobre una coincidencia que me tiene obsesionado desde hace años, desde que tomé notas de una conferencia llamada “La física de los datos”: la fórmula que mide la sorpresa de un mensaje es, letra por letra, la misma que mide el desorden de un gas. Te adelanto que no es casualidad.
Adivinar con preguntas de sí o no
Pienso un número del 1 al 8 y tú tienes que adivinarlo con preguntas de sí o no. Si eres listo, preguntas “¿es mayor que 4?”, y con eso descartas la mitad. Otra pregunta, otra mitad. Con tres preguntas lo tienes, siempre: . Con 16 opciones necesitarías cuatro; con una moneda, una sola. Cada respuesta de sí o no que parte las posibilidades por la mitad vale una unidad de información, y esa unidad se llama bit: el mismo sí o no que, escrito con voltajes, manejan las compuertas lógicas de un computador.
Hasta aquí todas las opciones eran igual de probables. Lo interesante empieza cuando no lo son.
La sorpresa se mide con un logaritmo
¿Qué le pediríamos a una medida de la sorpresa? Tres cosas razonables. Que lo seguro no sorprenda: si , sorpresa cero. Que lo raro sorprenda más que lo común. Y que si dos cosas independientes pasan a la vez, sus sorpresas se sumen: enterarme de que salió cara y de que salió un seis debería sorprenderme tanto como las dos noticias por separado.
La tercera condición es la que decide todo. En el capítulo anterior vimos que para eventos independientes las probabilidades se multiplican. Así que buscamos una función que convierta productos en sumas, y esa función es el logaritmo. Bajo condiciones muy suaves (que la sorpresa no salte de forma loca), es esencialmente la única. Definimos:
Algo de probabilidad trae un bit de sorpresa; algo de probabilidad , tres bits, igual que adivinar el número del 1 al 8. La base 2 solo elige la unidad: con el logaritmo natural la unidad se llama nat, y un nat es aproximadamente 1,44 bits. Y algo de probabilidad cero tendría sorpresa infinita, que es una forma elegante de decir que no debería pasar.
Entropía: la sorpresa promedio
Ahora tomemos una fuente que produce resultados con probabilidades : una moneda, un dado, las letras de un texto. Cada resultado trae su sorpresa. La entropía es el promedio de esas sorpresas, pesado por lo seguido que aparece cada una. Es un valor esperado, la integral de la sorpresa contra la medida de probabilidad:
(Con la convención : lo que nunca pasa no aporta.) Esta es la fórmula que Claude Shannon publicó en 1948 en Una teoría matemática de la comunicación, el artículo que fundó la teoría de la información. Juega con ella antes de seguir.
Repartida parejo: la mayor incertidumbre posible con estos resultados.
Una moneda justa tiene exactamente un bit. Una moneda cargada que cae cara nueve de cada diez veces tiene menos de medio bit: casi siempre sabes qué va a salir, y la rara vez que sale sello te sorprende mucho (más de tres bits), pero pasa tan poco que el promedio queda bajo. Una moneda de dos caras tiene cero. Y fíjate en el dado: por más que muevas los pesos, nunca pasas de bits, y solo llegas ahí cuando todas las caras pesan lo mismo.
Por qué lo parejo maximiza
Eso no es una propiedad del dado, es un teorema: entre todas las distribuciones sobre resultados, la uniforme es la de mayor entropía, y ninguna supera . La prueba cabe en una línea. El logaritmo es una función cóncava, así que el promedio de logaritmos nunca supera el logaritmo del promedio (es la desigualdad de Jensen):
y la igualdad se da exactamente cuando todas las son iguales, es decir, cuando la distribución es uniforme. La entropía mide qué tan repartida está la incertidumbre, y lo más repartido posible es repartir parejo.
Hay una lectura de esto que me parece muy sana. Si no sabes nada que haga preferir un resultado sobre otro, la distribución más honesta es la que no finge saber: la de máxima entropía. E. T. Jaynes convirtió esa idea en un principio general de razonamiento, el principio de máxima entropía: entre todas las distribuciones compatibles con lo que sabes, escoge la que menos información adicional supone.
Bits y compresión
La entropía no es solo una definición bonita; tiene un significado operativo que se puede cobrar. Supón que una fuente emite cuatro símbolos, A, B, C y D, con probabilidades . Con un código ingenuo usarías dos bits por símbolo (00, 01, 10, 11). Pero puedes darle a lo frecuente un código corto y a lo raro uno largo: A = 0, B = 10, C = 110, D = 111. Ningún código es el comienzo de otro, así que un mensaje se puede leer sin separadores, y el largo promedio es
No es coincidencia. El teorema de codificación de Shannon dice que, sin perder información, no se puede comprimir por debajo de bits por símbolo en promedio, y que, codificando bloques largos, uno se puede acercar a ese límite tanto como quiera. Es la misma idea del código Morse, donde la letra E, la más común del inglés, es un solo punto. Y explica algo que todo programador ha visto: un archivo ya comprimido, o uno lleno de ruido aleatorio, no se deja comprimir más. Su entropía por símbolo ya está cerca del máximo, y no queda redundancia que exprimir.
Aquí aparece también la idea que entrena casi todas las redes neuronales que clasifican: la entropía cruzada. Si el mundo produce datos con distribución pero tú los codificas como si vinieran de , pagas en promedio bits, que nunca es menos que . Entrenar un clasificador minimizando esa cantidad es, literalmente, pedirle que se sorprenda lo menos posible con los datos reales.
La misma fórmula en un gas
Ahora la coincidencia. Décadas antes de Shannon, Ludwig Boltzmann buscaba entender el calor desde los átomos. Su idea central fue distinguir entre lo que vemos (la temperatura, la presión: el macroestado) y la configuración exacta de cada partícula (el microestado). Muchísimos microestados distintos se ven iguales desde afuera. Si es cuántos son, la entropía del gas es
donde es la constante de Boltzmann, que solo convierte unidades. Si los microestados son igual de probables, cada uno tiene probabilidad , y la fórmula de Shannon da . Es la misma cantidad, en otras unidades. Y cuando los microestados no son equiprobables, la versión general de la física, la de Gibbs, es
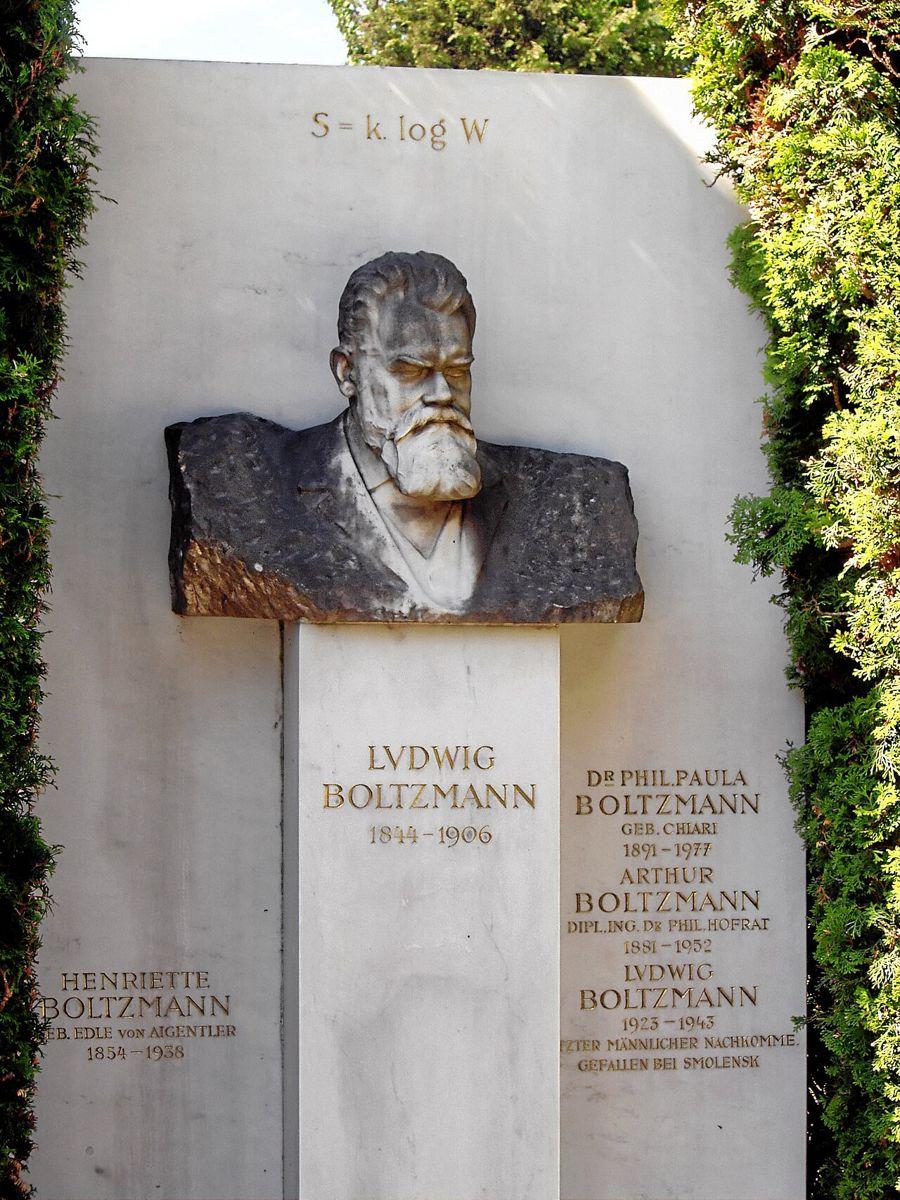
Hay que decir con cuidado qué significa esto, porque es fácil exagerar. No significa que un archivo de texto tenga temperatura. Significa que la entropía de un gas se puede leer como la información que te falta: cuántos bits necesitarías para precisar en qué microestado está, si solo conoces su temperatura y su presión. Un gas “ordenado” es uno del que, sabiendo poco, ya sabes casi todo. Y la conexión no es solo formal: el principio de Landauer establece que borrar un bit de memoria disipa como mínimo de calor, y eso se ha medido en el laboratorio. La información, al final, está escrita en algo físico y paga sus cuentas en la termodinámica.
Hay un detalle que me parece lo más profundo de todo: cuántos microestados “se ven iguales” depende de qué estás midiendo. Si solo miras la temperatura, muchos; si pudieras ver cada molécula, uno solo. Una lectura que me convence, la de Jaynes, es que la entropía no es una propiedad del gas a secas, sino del gas y de las variables con que elegiste describirlo. Es la misma lección del capítulo de medida, decir bien qué se está midiendo, y toca la pregunta de qué cuenta como real para quien observa.
Sorpresa, desorden, ignorancia
Así que tres palabras que parecían de mundos distintos resultan ser la misma: la sorpresa de un mensaje, el desorden de un gas y la ignorancia de quien mira. Las tres son un logaritmo de cuántas posibilidades siguen abiertas, promediado con cuidado. El logaritmo, por cierto, está ahí por la misma razón en todos los casos: porque las posibilidades de sistemas independientes se multiplican y queremos que su medida se sume. Es la propiedad de los números que hace que , puesta a trabajar.
Lo que me sigue pareciendo extraordinario es que nadie diseñó esa coincidencia. Boltzmann pensaba en átomos; Shannon, en líneas telefónicas. Llegaron a la misma fórmula porque los dos estaban haciendo la misma pregunta: dado lo que sé, ¿cuánto me falta por saber?